Excel・文書業務04
Excel の重複行を見つけて確認用に分離する
4列すべての値が完全一致する行を見つけ、元の行番号とともに新しい Excel ファイルへまとめます。最初に出現した行も含め、重複グループごとに確認します。
CSV 内の日付と作業時間を検証し、月ごとの記録件数と合計時間を CSV と棒グラフとして保存します。
この翻訳はAIで作成しました。コード、単位、数値は原文と併せて確認してください。各言語のネイティブ話者による校閲は、まだ完了していません。 English
対象読者毎月繰り返す作業集計を、簡単な Python コードで処理したい事務担当者
各行を1件の作業記録として扱い、その日付が属する月に hours を加算します。record_count は行数であり、人数や勤務日数ではありません。hours は10進時間です。1.50 は1時間30分を意味し、1時間50分ではありません。
付属データには、2026年1月から3月までの架空の作業記録が9件含まれています。これは既存の数値を月ごとに合計する演習であり、作業時間を測定したり performance を評価したりするための tool ではありません。
| 列 | 形式 | 検証ルール |
|---|---|---|
| record_id | R001 のような text | ファイル内で一意であること |
| date | 2026-01-06 | YYYY-MM-DD; 実在する日付であること |
| task | 資料 정리 | 空でないこと |
| hours | 2.50 | 0 以上の有限数で、小数点以下2桁まで |
title rows、total rows、カンマを含む数値を追加しないでください。スクリプトが duplicate ID を見つけた場合、二重計上を防ぐため停止します。task descriptions が同じでも、ID が異なる records は別々に数えます。
python --version
python -m pip install -r requirements.txt
python example.py
インストールにはインターネット接続が必要です。コード内の BASE は、現在の terminal folder ではなく example.py を基準に input と output の paths を設定します。
コードは date.fromisoformat で日付を検証し、YYYY-MM 形式の month keys を作成します。hours は Decimal で加算し、表には小数点以下2桁で書き込みます。plotting のときだけ通常の floating-point numbers に変換します。Agg mode では chart window を開かず PNG を保存します。
"""Summarize fictional work-log records by calendar month."""
import csv
import math
from collections import defaultdict
from datetime import date
from decimal import Decimal, InvalidOperation
from pathlib import Path

import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

BASE = Path(__file__).resolve().parent
HEADERS = ["record_id", "date", "task", "hours"]


def main():
    destination = BASE / "outputs"
    if destination.exists():
        raise ValueError("outputs already exists; rename it before running again.")
    totals = defaultdict(lambda: {"records": 0, "hours": Decimal("0")})
    seen = set()
    with (BASE / "work_log.csv").open(encoding="utf-8-sig", newline="") as file:
        reader = csv.DictReader(file)
        if reader.fieldnames != HEADERS:
            raise ValueError(f"Expected headers: {HEADERS}")
        for line, row in enumerate(reader, start=2):
            if None in row or any(value is None or not value.strip() for value in row.values()):
                raise ValueError(f"Row {line}: missing or extra field.")
            if row["record_id"] in seen:
                raise ValueError(f"Row {line}: duplicate record_id.")
            seen.add(row["record_id"])
            parsed_date = date.fromisoformat(row["date"])
            if parsed_date.isoformat() != row["date"]:
                raise ValueError(f"Row {line}: use YYYY-MM-DD dates.")
            try:
                hours = Decimal(row["hours"])
            except InvalidOperation as error:
                raise ValueError(f"Row {line}: hours must be a number.") from error
            if not hours.is_finite() or hours < 0 or hours.as_tuple().exponent < -2:
                raise ValueError(f"Row {line}: hours must be finite, nonnegative, with at most 2 decimals.")
            month = parsed_date.strftime("%Y-%m")
            totals[month]["records"] += 1
            totals[month]["hours"] += hours
    if not totals:
        raise ValueError("No work records were found.")

    months = sorted(totals)
    figure, axis = plt.subplots(figsize=(8, 4.6), layout="constrained")
    values = [float(totals[month]["hours"]) for month in months]
    if not all(math.isfinite(value) and math.isfinite(value * 1.2) for value in values):
        plt.close(figure)
        raise ValueError("Monthly total is too large to plot as a finite number.")
    bars = axis.bar(months, values, color="#2B6578", width=0.55)
    axis.bar_label(bars, labels=[f"{value:.2f}" for value in values], padding=4)
    axis.set(title="Monthly work hours | Fictional data", xlabel="Calendar month", ylabel="Hours")
    axis.set_ylim(0, max(values) * 1.2 if max(values) > 0 else 1)
    axis.spines[["top", "right"]].set_visible(False)
    axis.set_axisbelow(True)
    axis.grid(axis="y", alpha=0.2)
    destination.mkdir(exist_ok=False)
    with (destination / "monthly_summary.csv").open("x", encoding="utf-8-sig", newline="") as file:
        writer = csv.writer(file)
        writer.writerow(["month", "record_count", "total_hours"])
        for month in months:
            writer.writerow([month, totals[month]["records"], f"{totals[month]['hours']:.2f}"])
    figure.savefig(destination / "monthly_hours.png", dpi=160)
    plt.close(figure)
    total_hours = sum((values["hours"] for values in totals.values()), Decimal("0"))
    print(f"Records: {len(seen)}; months: {len(months)}; hours: {total_hours:.2f}")
    print("Created outputs/monthly_summary.csv and outputs/monthly_hours.png.")


if __name__ == "__main__":
    try:
        main()
    except (OSError, ValueError, csv.Error) as error:
        raise SystemExit(f"Stopped: {error}") from error
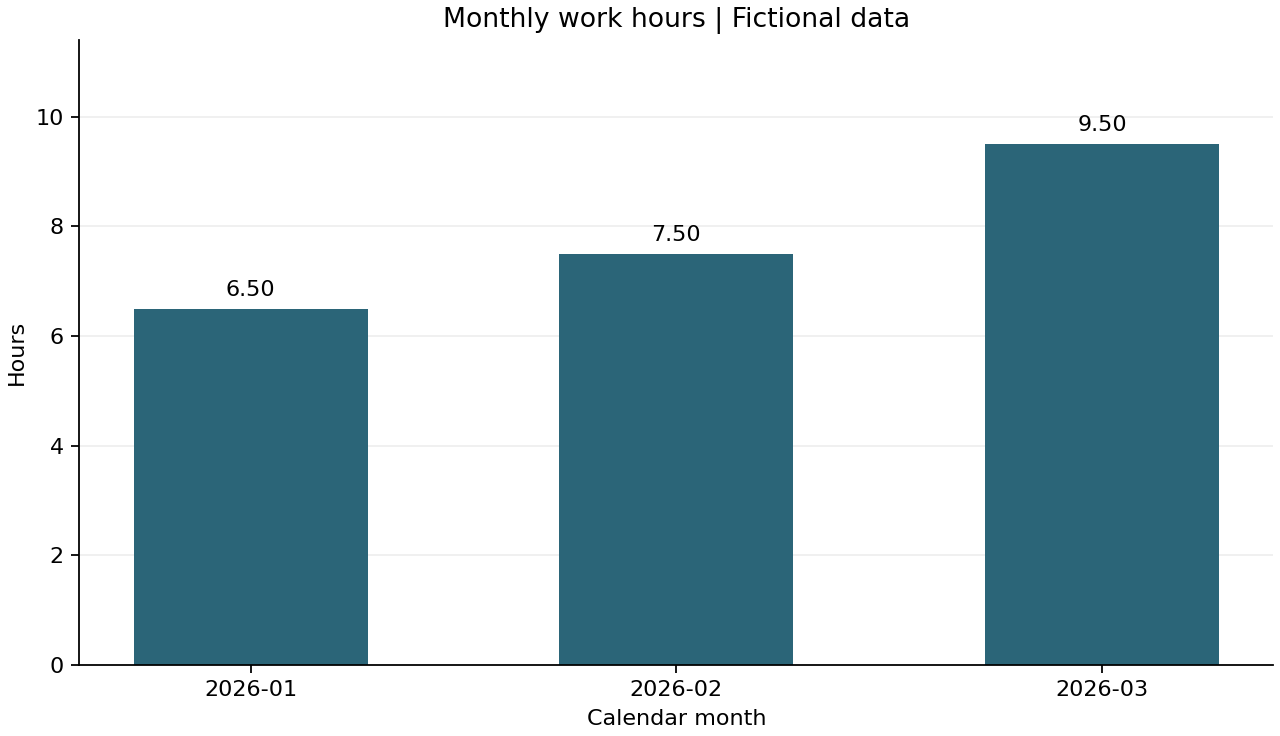
スクリプトは outputs/monthly_summary.csv と outputs/monthly_hours.png を作成します。chart には input に存在する months だけが表示され、year と month の順に並びます。英語の axis labels を使用することで、別の韓国語 font をインストールしなくても例を実行できます。
| month | record_count | total_hours |
|---|---|---|
| 2026-01 | 3 | 6.50 |
| 2026-02 | 3 | 7.50 |
| 2026-03 | 3 | 9.50 |
| 確認用の総合計 | 9 | 23.50 |
| 問題 | 修正方法 |
|---|---|
| duplicate record_id | 同じ record が2回入力されていないか確認します。 |
| day is out of range / Invalid isoformat | 2026-02-30 のような存在しない日付や、不正な date format を確認します。 |
| hours must be a number | hours には 2.5 のような数値だけを入力します。unit labels と thousands separators を削除します。 |
| hours must be finite… | 負の値、NaN、Infinity、小数点以下2桁を超える値がないか確認します。 |
| Korean text appears garbled | 元の CSV を UTF-8 で保存し直します。 |
| outputs already exists | 以前の結果を保持してから、result folder の名前を変更します。 |
Windows 11 (10.0.26200), CPython 3.12.14 (64-bit). openpyxl 3.1.5, Matplotlib 3.10.8. 各例で使用するライブラリは requirements.txt に固定されています。
コード、入力データ、実行手順が含まれています。展開して、まずREADME.txtを読んでください。
サンプルZIPをダウンロードサンプルコード、ファイル名、入力キーは原文のままです。翻訳本文のコマンドと確認手順も併せて参照してください。
独自に作成した練習用資料 · 元のファイルを別に保管してから実行してください。
説明と例は独自に作成しました。関連する動作や概念は、以下の公式資料で確認できます。