Comprobar primero el eje temporal y las unidades de un CSV de ensayo
Comprueba unidades, valores ausentes, números finitos y marcas de tiempo duplicadas o invertidas en datos sintéticos de demostración, y después guarda los resultados de la comprobación y un gráfico.
Contenido revisado 2026.09.19Incluye archivos de ejemplo
Ver el índice
La traducción se ha realizado con IA. Comprueba el código, las unidades y los valores junto con el original. La revisión por hablantes nativos de cada idioma aún no se ha completado. English
Para quién esIngenieros y principiantes que leen por primera vez un CSV de ensayo de vehículo con Python
Preparación
Ten preparados Python 3.12 y una terminal. Comprueba la versión con python --version.
Extrae todo el ZIP descargado y abre una terminal en la carpeta que contiene example.py.
Empieza con los datos de práctica incluidos y después compara los resultados con los archivos originales.
El synthetic_test.csv incluido contiene datos sintéticos de demostración. Utiliza s para el tiempo y km/h para la velocidad.
01Cuatro cosas que comprobar antes de crear un gráfico
Comprueba primero file structure, numbers, units y time order de los synthetic demonstration data. Poder leer los values no significa que las units sean correctas ni que los times estén bien. Este ejemplo comprueba que s y km/h estén indicados en cada input row y que time aumente en el original row order.
02Leer el CSV de entrada
Column
Valores incluidos y significado
dataset_note
Synthetic demonstration data
time
Elapsed time de 0.0 a 1.0
time_unit
s
speed
Speed values de 0 a 22
speed_unit
km/h
No añadas unit strings a las numeric cells. Registra las units en una column separada. time no puede ser negative y se requieren al menos dos samples. Este code no define un physically normal range para speed.
03Preparar los archivos y ejecutar el ejemplo
Extrae el ZIP y comprueba que el input file indicado en README.txt esté en la misma carpeta que example.py. No ejecutes el ejemplo desde dentro del archivo ZIP.
Ejecuta los commands siguientes uno por uno en la carpeta que contiene example.py. En Windows, si python no está disponible pero py sí, sustituye python en cada command por py -3.12.
Cuando aparezca el completion message, abre la nueva carpeta outputs. Si outputs ya existe, primero renómbrala para conservar los previous results y después vuelve a ejecutar el ejemplo.
La installation requiere internet connection. BASE en el code establece los input y output paths en relación con example.py, no con la current terminal folder.
04Código completo y condiciones de detención
Al leer cada row del CSV, comprueba missing values y units. math.isfinite rechaza NaN e infinity. Si el current time es menor o igual que el previous time, se detiene, por lo que no oculta problemas ordenando ni elimina arbitrariamente duplicate samples. outputs se crea únicamente después de completar el input check.
example.py
"""Check time order and declared units in explanatory synthetic test data.

This demonstrates file checks only. It makes no vehicle safety assessment.
"""
import csv
import json
import math
from pathlib import Path

import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

BASE = Path(__file__).resolve().parent
HEADERS = ["dataset_note", "time", "time_unit", "speed", "speed_unit"]
NOTE = "설명용 합성 데이터"


def read_samples():
    samples = []
    with (BASE / "synthetic_test.csv").open(encoding="utf-8-sig", newline="") as file:
        reader = csv.DictReader(file)
        if reader.fieldnames != HEADERS:
            raise ValueError(f"Expected headers: {HEADERS}")
        for line, row in enumerate(reader, start=2):
            if None in row or any(value is None or not value.strip() for value in row.values()):
                raise ValueError(f"Row {line}: missing or extra field.")
            if row["dataset_note"] != NOTE:
                raise ValueError(f"Row {line}: explanatory synthetic-data label is required.")
            if row["time_unit"] != "s" or row["speed_unit"] != "km/h":
                raise ValueError(f"Row {line}: expected units s and km/h; no automatic conversion.")
            time, speed = float(row["time"]), float(row["speed"])
            if not math.isfinite(time) or not math.isfinite(speed):
                raise ValueError(f"Row {line}: NaN and infinite values are not supported.")
            if time < 0:
                raise ValueError(f"Row {line}: elapsed time must be nonnegative.")
            if samples and time <= samples[-1][0]:
                raise ValueError(f"Row {line}: duplicate or decreasing time; check the source.")
            samples.append((time, speed))
    if len(samples) < 2:
        raise ValueError("At least two samples are required.")
    return samples


def main():
    destination = BASE / "outputs"
    if destination.exists():
        raise ValueError("outputs already exists; rename it before running again.")
    samples = read_samples()
    times, speeds = zip(*samples)
    intervals = [right - left for left, right in zip(times, times[1:])]
    report = {
        "dataset_note": NOTE,
        "scope": "File structure and numeric checks only; no vehicle safety assessment.",
        "sample_count": len(samples), "time_unit": "s", "speed_unit": "km/h",
        "start_time": times[0], "end_time": times[-1],
        "min_interval_s": min(intervals), "max_interval_s": max(intervals),
        "min_speed_kmh": min(speeds), "max_speed_kmh": max(speeds),
        "time_strictly_increasing": True,
    }
    figure, axis = plt.subplots(figsize=(8, 4.6), layout="constrained")
    axis.plot(times, speeds, "o-", color="#2B6578", linewidth=2)
    axis.set(title="Speed trace | Explanatory synthetic data", xlabel="Elapsed time (s)", ylabel="Speed (km/h)")
    axis.spines[["top", "right"]].set_visible(False)
    axis.grid(alpha=0.2)
    destination.mkdir(exist_ok=False)
    with (destination / "data_check.json").open("x", encoding="utf-8") as file:
        json.dump(report, file, ensure_ascii=False, indent=2)
    figure.savefig(destination / "synthetic_speed.png", dpi=160)
    plt.close(figure)
    print(f"Explanatory synthetic data: {len(samples)} samples, {times[0]:g}-{times[-1]:g} s.")
    print(f"Sample interval: {min(intervals):g}-{max(intervals):g} s; units: s, km/h.")
    print("Created outputs/data_check.json and outputs/synthetic_speed.png.")


if __name__ == "__main__":
    try:
        main()
    except (OSError, ValueError, csv.Error) as error:
        raise SystemExit(f"Stopped: {error}") from error
05Comprobar los resultados y el gráfico
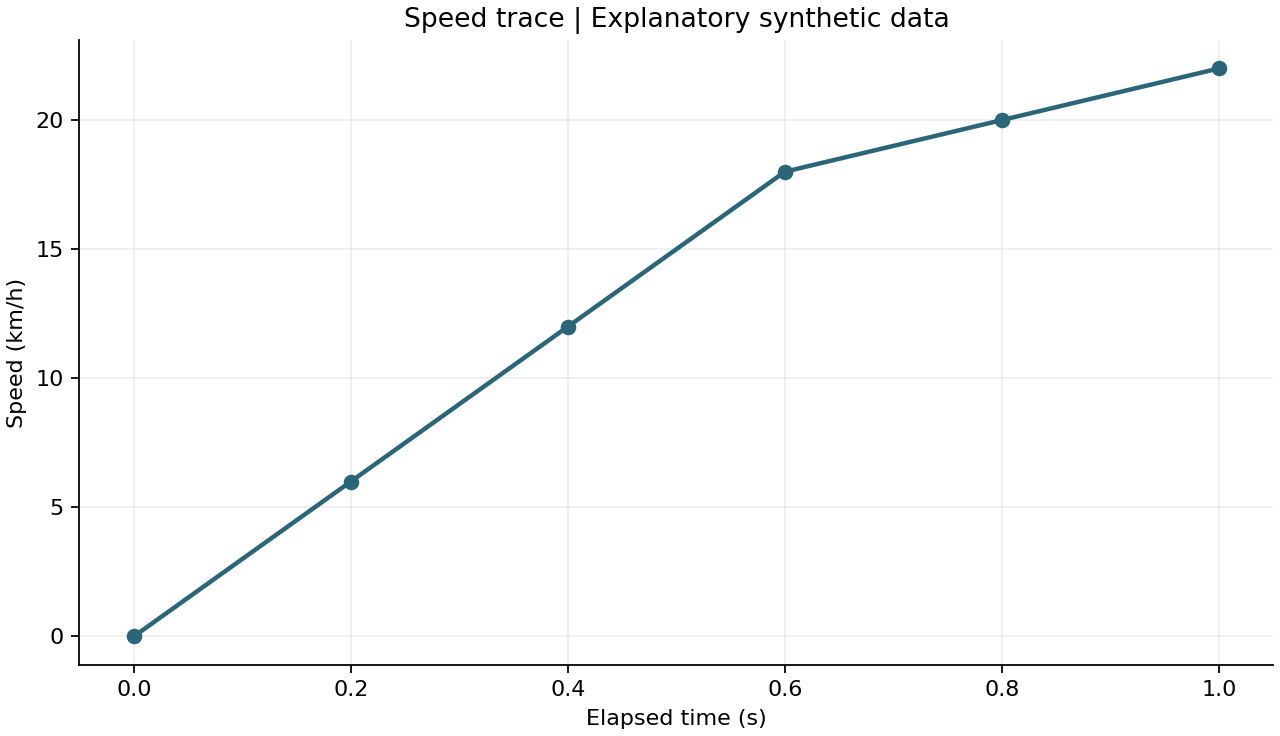
outputs/data_check.json registra las units, number of samples, time range y los minimum y maximum sampling interval. outputs/synthetic_speed.png es un chart de los mismos synthetic demonstration data.
Elemento
Resultados de los datos sintéticos de demostración incluidos
Samples
6
Time range
0.0~1.0 s
Sampling interval
About 0.2 s
Speed minimum / maximum
0 / 22 km/h
Time increasing
true
Speed curve of synthetic demonstration data. Time 0–1 s, speed 0–22 km/h.
Debido a floating-point representation, el sampling interval del JSON puede aparecer como 0.19999999999999996. No es un número que afirme una precision adicional de los input values ni de la measurement resolution.
06Introducir errores para probarlo
Comprueba que sample_count en el normal result sea 6 y que time_unit sea s.
En una practice folder recién extraída, cambia time de la tercera data row para que sea igual al previous value, 0.2. Al ejecutar, debería detenerse con el mensaje duplicate or decreasing time.
En otra fresh copy, cambia un speed_unit a m/s. Comprueba que aparezca el expected units message y que outputs no se cree.
Conserva el original input file y realiza los error experiments únicamente en copies.
07Qué mirar cuando la comprobación se detiene
Message
Qué comprobar en el original
expected units s and km/h
Comprueba que los export settings coincidan con las units de cada row. El code no convierte automáticamente.
duplicate or decreasing time
Comprueba si el time order cambió durante un restart, duplicate samples o file merging.
NaN and infinite values
Comprueba el original por missing samples o calculation errors.
synthetic-data label is required
Mantén la label que indica que son synthetic demonstration data únicamente para este tutorial.
missing or extra field
Comprueba el número de commas, blank cells y column names.
08Qué sigue siendo necesario comprobar después de pasar la revisión
No impone una rule que obligue a que el time interval sea constante. Si min_interval_s y max_interval_s difieren, comprueba por separado el sampling period del original.
No realiza filtering, interpolation, unit conversion, sensor calibration, time synchronization ni noise judgments.
Solo comprueba la notation de las unit columns. No puede confirmar que los actual values se hayan medido realmente en esa unit ni que el sensor esté en el channel correcto.
Es una práctica de file handling limitada a los data incluidos. No la interpretes como una validation tool utilizable para real vehicle test procedures o safety judgments.
Registro de ejecución y verificación
Windows 11 (10.0.26200), CPython 3.12.14 (64-bit). openpyxl 3.1.5, Matplotlib 3.10.8. Las libraries utilizadas por cada ejemplo están fijadas en requirements.txt.
Se comprobaron 6 samples de synthetic demonstration data, time range, units e intervals
Se comprobaron errors por unit mismatch, duplicate or reversed times, NaN y missing values
Se comprobó que el original hash no cambia, que se rechazan existing results y que se crea el PNG
Límites de la verificación
Solo se comprobaron synthetic demonstration data. No se evaluaron real measurement data ni vehicle safety.
El código de ejemplo, los nombres de archivo y las claves de entrada se mantienen como en el original. Consulta también los comandos y los pasos de comprobación del texto traducido.
Material de práctica original · Guarda los archivos originales por separado antes de ejecutarlo.
Fuentes de referencia
Las explicaciones y los ejemplos son de elaboración propia. Puedes consultar los comportamientos y conceptos relacionados en las siguientes fuentes oficiales.
Valida tres archivos CSV sintéticos de demostración y después superpone en un mismo gráfico las curvas que comparten las mismas muestras temporales y unidades de aceleración.
Si solo colocas lado a lado los valores de tensión máxima, las diferencias de malla, intervalo de salida y ubicación de evaluación pueden parecer cambios de diseño. Construye una tabla de condiciones de comparación a partir de casos sintéticos y registra la diferencia numérica junto con el alcance que realmente puede evaluarse.
Aplica una media móvil retrospectiva de tres muestras a datos sintéticos de aceleración, verifica manualmente cada valor filtrado y deja explícito el retraso de alineación de una muestra introducido por el filtro. El CSV original permanece sin cambios y los datos procesados se escriben en una carpeta nueva.
Convierte datos sintéticos de velocidad y aceleración de vehículos a unidades SI coherentes y después vuelve a convertir los resultados para comprobar la aritmética. El script conserva el CSV original y escribe los valores convertidos en una nueva carpeta de salida.