Comparar varias condiciones de ensayo en el mismo eje temporal
Valida tres archivos CSV sintéticos de demostración y después superpone en un mismo gráfico las curvas que comparten las mismas muestras temporales y unidades de aceleración.
Contenido revisado 2026.09.19Incluye archivos de ejemplo
Ver el índice
La traducción se ha realizado con IA. Comprueba el código, las unidades y los valores junto con el original. La revisión por hablantes nativos de cada idioma aún no se ha completado. English
Para quién esPrincipiantes de Python en el sector automotriz que quieren superponer resultados de ensayo de varias condiciones
Preparación
Ten preparados Python 3.12 y una terminal. Comprueba la versión con python --version.
Extrae por completo el ZIP descargado y abre una terminal en la carpeta que contiene example.py.
Empieza con los datos de práctica incluidos y después compara los resultados con los archivos originales.
case_a.csv, case_b.csv y case_c.csv de la carpeta inputs son todos datos sintéticos de demostración.
Todas las entradas utilizan time en s, acceleration en m/s^2 y las mismas time samples.
01Alinear las condiciones necesarias para la comparación
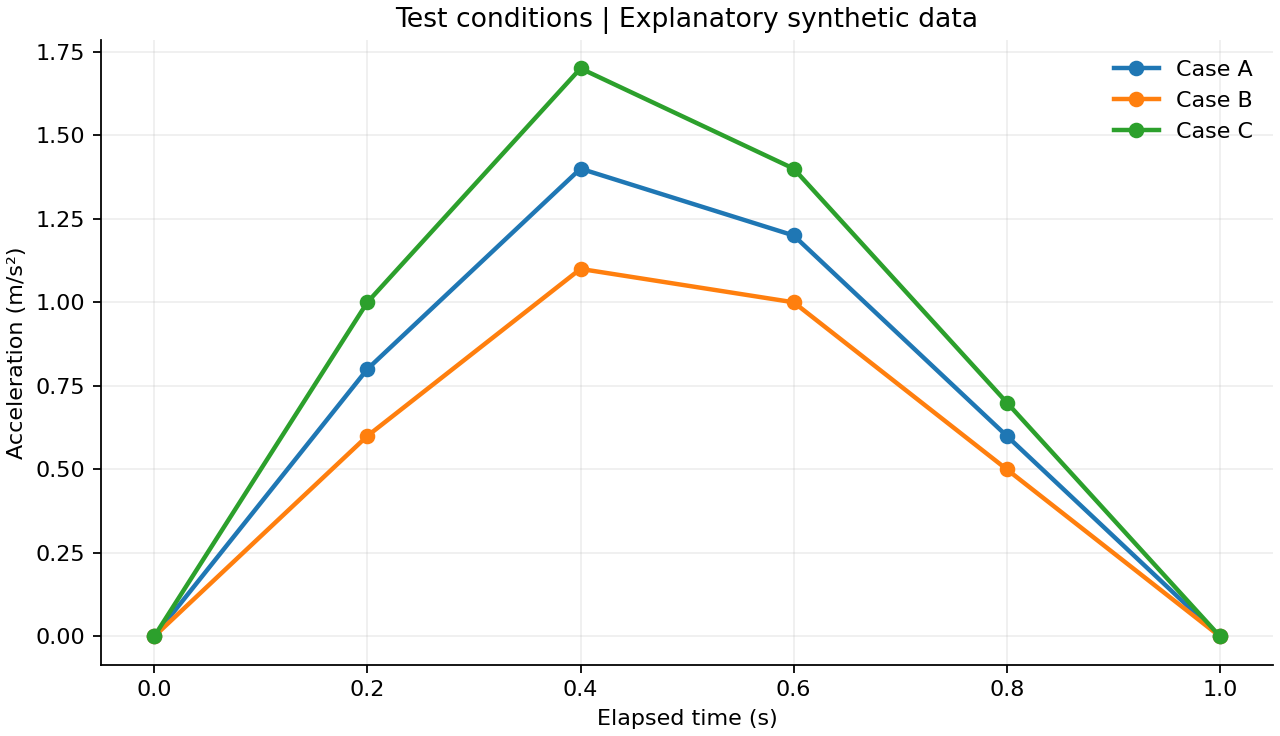
Para superponer varias curvas en un mismo gráfico, time y las units del eje vertical deben significar lo mismo. Este ejemplo representa los datos sintéticos de demostración Case A, Case B y Case C sobre ejes comunes de time en s y acceleration en m/s^2. Los nombres de condition se leen de la columna condition de cada archivo.
02Preparar la carpeta y el formato de entrada
El script lee los archivos .csv de la carpeta inputs por orden de nombre. Debe haber al menos dos archivos y cada archivo debe contener una sola condition. Cada fila debe tener seis columnas: dataset_note, condition, time, time_unit, acceleration y acceleration_unit.
Campo
Ejemplo incluido
dataset_note
Synthetic demonstration data
condition
Case A (ASCII letters and numbers)
time / time_unit
0.0 / s
acceleration / acceleration_unit
0.8 / m/s^2
Este ejemplo solo compara cuando los time arrays de los archivos son exactamente iguales. Se detiene si difieren el número de samples, el tiempo inicial o cualquier time value. El eje del gráfico muestra la unidad compartida como m/s².
03Preparar los archivos y ejecutar el ejemplo
Extrae el ZIP y comprueba que el archivo de entrada indicado en README.txt esté en la misma carpeta que example.py. No ejecutes el ejemplo desde dentro del archivo ZIP.
Ejecuta los comandos siguientes, una línea cada vez, en la carpeta que contiene example.py. En Windows, si python no está disponible pero sí py, sustituye python en cada comando por py -3.12.
Cuando aparezca el mensaje de finalización, abre la nueva carpeta outputs. Si outputs ya existe, cámbiale primero el nombre para conservar los resultados anteriores y después vuelve a ejecutar el ejemplo.
La instalación requiere conexión a internet. BASE en el código establece las rutas de entrada y salida relativas a example.py, no a la carpeta actual de la terminal.
04Código completo y comprobaciones previas a la comparación
Después de comprobar el time order y las units de cada archivo, comprueba si hay nombres de condition duplicados. Compara los arrays restantes con el time array del primer archivo y añade líneas a un único Axes solo cuando todos coinciden. Sorting, time shifting, interpolation y unit conversion no se realizan automáticamente.
example.py
"""Overlay explanatory synthetic test conditions on the same axes.

All files must have the same explicit units and matching time samples.
No interpolation, clock shifting, filtering, or safety assessment is performed.
"""
import csv
import math
from pathlib import Path

import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

BASE = Path(__file__).resolve().parent
HEADERS = ["dataset_note", "condition", "time", "time_unit", "acceleration", "acceleration_unit"]
NOTE = "설명용 합성 데이터"


def read_condition(path):
    times, values = [], []
    label = None
    with path.open(encoding="utf-8-sig", newline="") as file:
        reader = csv.DictReader(file)
        if reader.fieldnames != HEADERS:
            raise ValueError(f"{path.name}: expected headers {HEADERS}")
        for line, row in enumerate(reader, start=2):
            if None in row or any(value is None or not value.strip() for value in row.values()):
                raise ValueError(f"{path.name}:{line}: missing or extra field.")
            if row["dataset_note"] != NOTE:
                raise ValueError(f"{path.name}:{line}: synthetic-data label is required.")
            if row["time_unit"] != "s" or row["acceleration_unit"] != "m/s^2":
                raise ValueError(f"{path.name}:{line}: expected units s and m/s^2; no automatic conversion.")
            if not row["condition"].isascii():
                raise ValueError(f"{path.name}:{line}: use an ASCII condition label for portable plotting.")
            label = row["condition"] if label is None else label
            if row["condition"] != label:
                raise ValueError(f"{path.name}:{line}: condition label changes within one file.")
            time, value = float(row["time"]), float(row["acceleration"])
            if not math.isfinite(time) or not math.isfinite(value) or time < 0:
                raise ValueError(f"{path.name}:{line}: expected finite values and nonnegative time.")
            if times and time <= times[-1]:
                raise ValueError(f"{path.name}:{line}: duplicate or decreasing time.")
            times.append(time)
            values.append(value)
    if len(times) < 2:
        raise ValueError(f"{path.name}: at least two samples are required.")
    return label, times, values


def main():
    destination = BASE / "outputs"
    if destination.exists():
        raise ValueError("outputs already exists; rename it before running again.")
    paths = sorted((BASE / "inputs").glob("*.csv"))
    if len(paths) < 2:
        raise ValueError("At least two CSV files are required in inputs.")
    conditions = [read_condition(path) for path in paths]
    if len({label for label, _, _ in conditions}) != len(conditions):
        raise ValueError("Condition labels must be unique across files.")
    reference_times = conditions[0][1]
    if any(times != reference_times for _, times, _ in conditions[1:]):
        raise ValueError("Time samples do not match; check alignment before comparison.")

    figure, axis = plt.subplots(figsize=(8, 4.6), layout="constrained")
    for label, times, values in conditions:
        axis.plot(times, values, marker="o", linewidth=2, label=label)
    axis.set(title="Test conditions | Explanatory synthetic data", xlabel="Elapsed time (s)", ylabel="Acceleration (m/s²)")
    axis.spines[["top", "right"]].set_visible(False)
    axis.grid(alpha=0.2)
    axis.legend(frameon=False)
    destination.mkdir(exist_ok=False)
    with (destination / "comparison_summary.csv").open("x", encoding="utf-8-sig", newline="") as file:
        writer = csv.writer(file)
        writer.writerow(["dataset_note", "condition", "sample_count", "min_acceleration", "max_acceleration", "unit"])
        for label, _, values in conditions:
            writer.writerow([NOTE, label, len(values), min(values), max(values), "m/s^2"])
    figure.savefig(destination / "synthetic_comparison.png", dpi=160)
    plt.close(figure)
    print(f"Explanatory synthetic data: {len(conditions)} conditions, {len(reference_times)} matching time samples each.")
    print("Created outputs/comparison_summary.csv and outputs/synthetic_comparison.png.")


if __name__ == "__main__":
    try:
        main()
    except (OSError, ValueError, csv.Error) as error:
        raise SystemExit(f"Stopped: {error}") from error
05Leer el gráfico y el CSV de resumen
Las tres conditions se superponen en outputs/synthetic_comparison.png. outputs/comparison_summary.csv almacena el número de samples y la acceleration minimum y maximum de cada condition. Estas cifras son un resumen sencillo de datos sintéticos de demostración.
Condition
Samples
Minimum
Maximum
Case A
6
0.0 m/s²
1.4 m/s²
Case B
6
0.0 m/s²
1.1 m/s²
Case C
6
0.0 m/s²
1.7 m/s²
Acceleration comparison of synthetic demonstration data Cases A, B, and C. Three curves using the same 0–1 s time and m/s² axes.
En la sample de 0.4 s, los valores de las tres curvas son 1.4, 1.1 y 1.7 m/s². Las líneas del gráfico conectan las samples; no crean nuevos measured values entre ellas.
06Pasos para confirmar que los ejes coinciden
Comprueba que Case A, Case B y Case C de la legend del gráfico coincidan con los condition values de los archivos de entrada.
Comprueba Elapsed time (s) en el x-axis y Acceleration (m/s²) en el y-axis.
Compara los valores de los tres archivos CSV en 0.4 s con el gráfico y la summary table.
En una nueva copia de práctica, cambia un time value de case_b.csv a 0.41. Comprueba que se detenga con el mensaje Time samples do not match.
En otra copia nueva, cambia acceleration_unit a g y comprueba que se detenga sin realizar conversión automática.
07Encontrar por qué se detiene la comparación
Mensaje
Qué comprobar
expected units s and m/s^2
Comprueba las units y la notación reales en el archivo exportado.
duplicate or decreasing time
Comprueba el time order en ese archivo y fila.
Time samples do not match
Comprueba el tiempo inicial, sampling interval y missing samples. No sobrescribas simplemente los times sin conocer la causa.
Condition labels must be unique
Utiliza un condition name diferente para cada archivo.
condition label changes
Comprueba que un archivo no mezcle varias conditions.
At least two CSV files
Comprueba que los archivos de entrada estén en la carpeta inputs.
08Lo que el gráfico por sí solo no puede decirte
Incluso con el mismo time axis numérico, el trigger o reference time pueden ser diferentes. Comprueba por separado la base de alignment en ensayos reales.
Solo se permiten time arrays exactamente idénticos. Approximate matching, resampling, interpolation y time-delay correction están fuera del alcance.
El código no juzga si distintas sensor locations, coordinate systems, sampling filters o test conditions son comparables.
El sample maximum no garantiza el verdadero maximum entre samples. El gráfico no proporciona pass/fail, performance ranking ni juicios de seguridad.
Registro de ejecución y verificación
Windows 11 (10.0.26200), CPython 3.12.14 (64-bit). openpyxl 3.1.5, Matplotlib 3.10.8. Las bibliotecas utilizadas por cada ejemplo están fijadas en requirements.txt.
Se comprobaron 3 conditions × 6 samples de datos sintéticos de demostración y los valores minimum y maximum
Se comprobaron errores de unit mismatch, duplicate o reversed times, mismatched time arrays y duplicate condition names
Se comprobó que los hashes originales permanecen sin cambios, que los outputs existentes se rechazan y que se crea el PNG
Límites de la verificación
No se evaluaron la comparabilidad de test conditions reales, time synchronization, measurement uncertainty ni seguridad.
El código de ejemplo, los nombres de archivo y las claves de entrada se mantienen como en el original. Consulta también los comandos y los pasos de comprobación del texto traducido.
Material de práctica original · Guarda los archivos originales por separado antes de ejecutarlo.
Fuentes de referencia
Las explicaciones y los ejemplos son de elaboración propia. Puedes consultar los comportamientos y conceptos relacionados en las siguientes fuentes oficiales.
Comprueba unidades, valores ausentes, números finitos y marcas de tiempo duplicadas o invertidas en datos sintéticos de demostración, y después guarda los resultados de la comprobación y un gráfico.
Si solo colocas lado a lado los valores de tensión máxima, las diferencias de malla, intervalo de salida y ubicación de evaluación pueden parecer cambios de diseño. Construye una tabla de condiciones de comparación a partir de casos sintéticos y registra la diferencia numérica junto con el alcance que realmente puede evaluarse.
Aplica una media móvil retrospectiva de tres muestras a datos sintéticos de aceleración, verifica manualmente cada valor filtrado y deja explícito el retraso de alineación de una muestra introducido por el filtro. El CSV original permanece sin cambios y los datos procesados se escriben en una carpeta nueva.
Convierte datos sintéticos de velocidad y aceleración de vehículos a unidades SI coherentes y después vuelve a convertir los resultados para comprobar la aritmética. El script conserva el CSV original y escribe los valores convertidos en una nueva carpeta de salida.